
Dernière mise à jour : Août 2023 - v.1.2
Notre module Analytics Database Connectivity complète les analyses intégrées fournies sur notre plateforme. Il vous permet de réaliser des analyses et des rapports personnalisés sur vos données Bloomflow via les outils de votre choix.
Notre offre
Nous vous fournissons un accès à une base de données PostgreSQL hébergée dans le cloud, contenant des données structurées pour l'analyse. L'étendue complète des informations disponibles est décrite dans les sections "Modèle de données" et "Description détaillée des données".
La base de données est déployée et maintenue par Bloomflow.
Elle peut être hébergée sur AWS, Azure ou OVH (généralement le même fournisseur cloud que celui choisi pour l'hébergement de votre plateforme).
Les données sont actualisées quotidiennement.
Comment ça marche ?
Il existe deux manières principales d'exploiter les données de Bloomflow dans votre outil BI : soit par une intégration dans votre pile de données (data stack), soit par un accès direct.
1. Intégration dans votre pile de données (Data Stack)
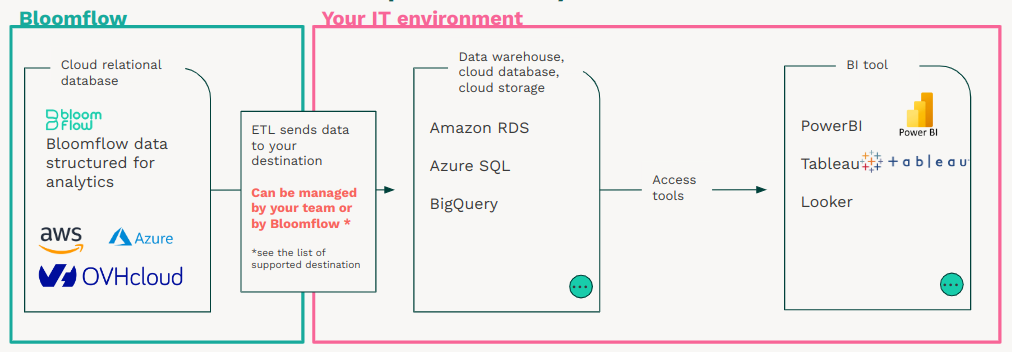 Les données sont envoyées dans vos propres systèmes (base de données cloud ou sur site). Selon le type de base de données, Bloomflow peut gérer ce processus ETL (Extract Transform Load). Pour ce faire, Bloomflow s'appuie sur une version auto-hébergée de l'outil open-source Airbyte. Ainsi, toutes les destinations supportées par Airbyte peuvent être gérées, sous réserve que vous nous fournissiez les identifiants de connexion appropriés (PostgreSQL, BigQuery, Redshift, Azure SQL, etc.).
2. Accès direct avec votre outil BI
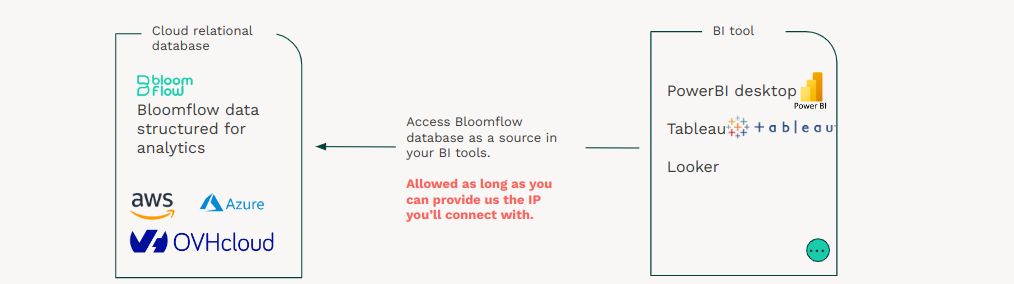
Il est parfois possible de se connecter directement aux données Bloomflow depuis votre outil BI, sous deux conditions :
PostgreSQL est une source disponible dans votre outil BI (la plupart des outils du marché supportent cette option).
Vous êtes en mesure de nous fournir l'adresse IP fixe depuis laquelle vous vous connecterez. Ceci est impératif pour des raisons de sécurité afin d'empêcher tout accès non autorisé.
Note : Il existe des limitations connues avec le service PowerBI. S'il est possible de se connecter via PowerBI Desktop, les rapports publiés sur PowerBI Service ne pourront pas être actualisés automatiquement.
Modèle de données
La base de données suit un modèle relationnel.
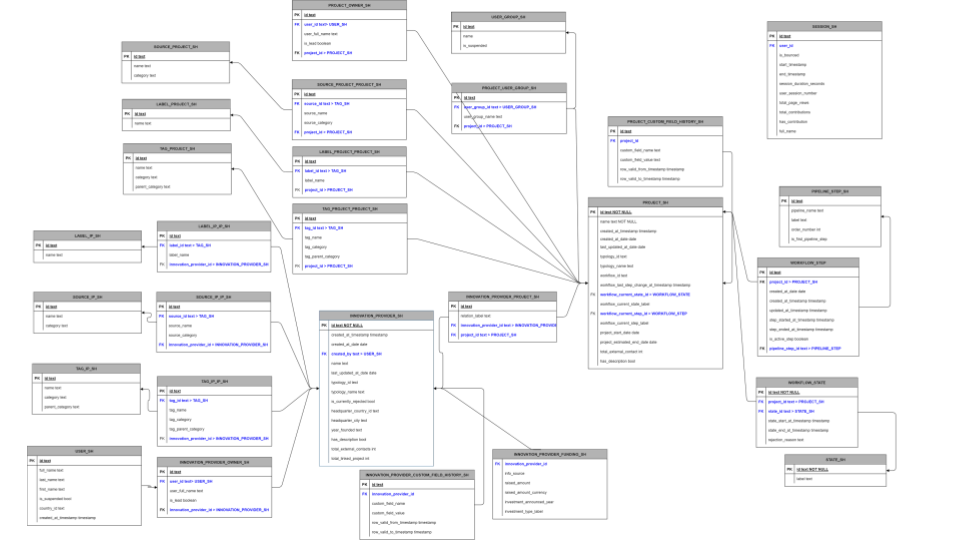
Bien que le modèle soit principalement relationnel, certains champs ont été mis à disposition dans plusieurs tables pour éviter au maximum les jointures inutiles, facilitant ainsi la création de tableaux de bord en connexion directe.
Les données incluent toutes les informations nécessaires pour reconstruire les analyses intégrées de Bloomflow, ainsi que tous les champs personnalisés et des informations supplémentaires sur l'utilisation de la plateforme (comme les événements de vues de pages).
Description détaillée des données
innovation_provider_sh : Table unique contenant les informations sur tous les types de fournisseurs d'innovation (startups, académiques, VCs, etc.).
Les types de fournisseurs sont différenciés via le champ
typology_id(outypology_name).Le champ
has_descriptionest un booléen qui est faux (false) si aucune description n'est fournie pour cet élément sur la plateforme.
innovation_provider_custom_field_history_sh : Table regroupant tous les champs personnalisés liés aux fournisseurs d'innovation.
Inclut une historisation native basée sur le modèle SCD de type 2. Pour accéder à la valeur actuelle d'un champ personnalisé pour un fournisseur donné, filtrez par
row_valid_to_timestamp IS NULL.
innovation_provider_funding_sh : Table contenant tous les financements liés au fournisseur d'innovation.
innovation_provider_project_sh : Table de jointure entre les fournisseurs d'innovation et les projets.
Chaque fournisseur est lié à au moins un projet.
Bien que cela n'apparaisse pas dans l'interface utilisateur, chaque fournisseur (startup, partenaire, etc.) est lié à ses workflows via un projet dont le champ
typology_id = 'process'. Par exemple, si vous avez une startup avec 2 workflows et 3 projets liés dans son écosystème, cette startup sera liée à 5 projets dans la tableproject_sh, dont deux avec le champtypology_id = 'process'.
project_sh : Table de tous les projets, incluant ceux qui lient les fournisseurs d'innovation à leurs workflows.
Chaque projet est lié à un seul workflow. C’est pourquoi les informations relatives aux workflows sont incluses dans cette table. Pour plus de commodité, vous y trouverez l'étape (
step) et l'état (state) actuels du workflow lié au projet. Si vous devez accéder à l'historique des différents états et étapes, utilisez les tablesworkflow_step_shetworkflow_state_sh.
workflow_step_sh : Enregistre toutes les étapes par lesquelles un workflow est passé au fil du temps.
Pour obtenir toutes les étapes d'un workflow spécifique, filtrez par
project_id.created_at_timestampetstep_started_at_timestampindiquent quand le workflow est passé à une étape donnée. Notez que ces deux horodatages sont générés par le système, mais le second peut être mis à jour par l'utilisateur.
pipeline_step_sh : Liste toutes les étapes de votre pipeline correspondant aux différentes typologies.
workflow_state_sh : Enregistre tous les différents états (en cours, terminé, etc.) par lesquels un workflow est passé.
Lorsqu'un workflow passe par un état de rejet, un motif de rejet peut être renseigné. Si ce motif correspond à l'un des motifs préconfigurés dans la plateforme, il sera affiché. Si le motif enregistré est un texte libre, la valeur du champ sera "other".
project_user_group_sh : Table de jointure entre le projet et
user_group. Utilisée pour accéder au groupe d'utilisateurs actuel auquel un workflow est rattaché.user_group_sh : Liste tous les groupes d'utilisateurs de la plateforme.
innovation_provider_owner_sh et project_owner_sh : Tables de jointure pour obtenir tous les contacts internes d'un fournisseur ou d'un projet.
Le champ
is_lead = truesi le contact interne est défini comme responsable (lead).Le champ
user_full_nameest inclus dans cette table pour éviter une jointure avecuser_shsi seul le nom complet est nécessaire.
source_project_project_sh et source_ip_ip_sh : Tables de jointure entre les sources et les projets/fournisseurs.
source_nameetsource_categorysont inclus pour éviter les jointures avec les tablessource_ip_shetsource_project_sh. C'est utile pour obtenir une répartition des sources liées à vos projets. Cependant, pour afficher les sources qui ne sont actuellement liées à aucun projet, vous devrez utiliser la tablesource_project_sh.
source_project_sh et source_ip_sh : Référentiel de toutes les sources pour les projets et fournisseurs d'innovation.
tag_project_project_sh, tag_ip_ip_sh, label_project_project_sh, label_ip_ip_sh, tag_project_sh, tag_ip_sh, label_project_sh, label_ip_sh : Identique aux points précédents, mais respectivement pour les tags et les labels.
Historique des modifications du modèle de données (Changelog)
N/A
Et ensuite ?
Le modèle de la base de données est susceptible d'être enrichi au fil du temps. Ces modifications seront documentées dans la section "Changelog" de cette documentation. Dans tous les cas, tous les utilisateurs de ce module seront informés bien à l'avance de l'entrée en vigueur de tels changements.
N'hésitez pas à contacter votre Customer Success Manager si vous souhaitez obtenir plus d'informations sur cette offre.
Commentaires
0 commentaire
Vous devez vous connecter pour laisser un commentaire.